
総務の担当者が、社内規程に答えるGPTsを作った。知識ファイルには、規程の文書を入れた。
社員の一人が、出張旅費の上限を尋ねた。
GPTsの答えは、改定前の金額。
社員がその金額を信じて申請すれば、精算は古い規程のまま進みかねない。社内規程に答えるAIが、社内の規程を崩す。
AIは、なぜ新しい規程を読まなかったのか。
答えが外れた原因は、二つしかない
資料を入れたのに、答えが外れる。原因は二つに分かれる。
一つ目は、関係する部分を取り出し損ねること。
二つ目は、取り出した資料自体の古さや誤りだ。
ふつうは、AIの読み落としを疑う。冒頭のGPTsは、違った。
知識ファイルの中には、旧版と新版の規程が並んで入っていた。
検索は旧版を正確に拾い、古い答えを正確に返した。二つ目の典型である。
うちのAIは社内資料を全部読んでいる、という説明は、旧版も全部読んでいる、という意味でもある。
知識ファイルの正体は、検索してから答える仕組みだ
世間はよく、知識ファイルとRAGを反対側に置いて比べる。
RAGと聞けば、ふつうは社内のデータベースにつなぐ大がかりな仕組みを思い浮かべる。GPTsにファイルを入れる手軽な方法とは、別物に見える。
実のところ、GPTsの知識ファイルはRAGの一つの形である。
RAG(Retrieval Augmented Generation、検索拡張生成)は、検索してから答える方法だ。取り出した資料を材料に、AIに答えを作らせる。
二つの中で動く流れは、同じである。
- 資料を小さな塊に分けて、ベクトル化(数値の配列に変えること)する
- 質問との近さを計算する
- 近い塊を取り出して、答えを作る
数値にすれば、コンピュータは意味の近さを計算できる。
OpenAIの説明(2024年時点)では、GPTsは質問に応じて知識ファイルを検索する。関係する部分を取り出して、答えに使う。
資料が短い場合などには、全文を渡す場合もあるという。大きな流れは、RAGと同じだ。

謎は、ここで解ける。古い資料を正確に検索する仕組みは、古い答えを正確に返す。
差がつくのは、中身を誰がいつ入れ替えるかだ
知識ファイルは静的で、RAGは動的。そんな分け方がある。
ただ、静と動の違いは、仕組みの違いとは別物だ。比べるべき軸は、検索先の中身を、誰がいつ入れ替えるかである。
知識ファイルの中身は、作った人が差し替えたときに入れ替わる。取り出し方を調整する幅はわずかで、手間は小さい。
自社で組むRAGの中身は、連携先の更新とともに入れ替わる。
RAGなら、資料の分け方や検索の方式を選べる。代わりに、手間は大きくなる。
中身が固まった少量の資料なら、知識ファイルの手軽さが効く。日々変わる情報や膨大な資料なら、自分で管理できるRAGが候補になる。
知識ファイルの場合、旧版を抜き出して新版に差し替える役は、作った人にある。
作った人が手を止めれば、旧版は箱に残り続ける。規程を改定するたびに、古い答えの種が一つ増える。
入れる前の仕分けで、答えの質に差がつく
資料は入れる前に、正とする版、旧版、参考の三つに分ける。旧版の規程は、知識ファイルから外す。
何を根拠に答えさせるかは、作る人の前提だ。前提を言葉にして資料を選ぶ力が、作る人の問う力になる。
答えの出どころを示させれば、二つの原因を見分けられる。
今日からできる三つの手当て
一つ目に、手元の資料を、正とする版、旧版、参考に分ける。
二つ目に、旧版の規程を知識ファイルから外す。
三つ目に、GPTsの指示の欄へ、答えの出どころを示させる文面を足す。
次の文面のかっこの中を、自分のGPTsに書き換えて使える。
答えには、根拠にした知識ファイルの名前と、改定日を添えてください。
根拠にする資料:(例:2025年4月改定の出張旅費規程)
同じ規程の版が二つ以上見つかったときは、改定日の新しい版で答え、古い版の存在も書き添えてください。
答えに根拠のファイル名と改定日が並べば、取り出し損ねたのか資料が誤っていたのかを見分けられる。
古い金額を返した犯人は、AIではなかった
出張旅費の上限を尋ねた社員に、GPTsは正確に答えた。正確に、旧版の金額を。
改定前の金額を返した犯人は、AIではない。旧版を箱に残した仕分けである。
拙著『GoogleのAI NotebookLM 意思決定の強化書』の2章1節「ソースの品質がすべての土台」に、この記事の考え方を書きました。読むと、検索の仕組みを比べる前に、検索先の資料のどれが古く、どれが事実でないかを仕分けられるようになります。
同じ資料を見ているのに、なぜ結論が割れるのか。
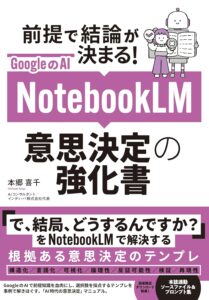
『GoogleのAI NotebookLM 意思決定の強化書』
前提が結論を決める。意思決定を根拠、前提、結論の三層に分け、前提を対象、目的、制約、評価基準の四つで言葉にする本です。
読み終えたとき、手元に残るもの
- 意思決定の設計図になる前提リスト
- 資料を事実、意見、噂、ゴミに仕分けるFORT
- 同じ物差しで比べる選択肢表と採点表
- 始める条件と止める条件を書いた決定書
NotebookLMは2026年7月にGemini Notebookへ名称が変わりました。本の手法は、使うAIの種類を問いません。