
熟練者に「AIがまとめた、あなたの判断基準です」と見せると、多くの場合「だいたい合っている」と返ってきます。この「だいたい」の中に、言葉にしたかった暗黙知のほとんどが沈んでいます。
この記事の中心命題は、大規模言語モデル(LLM)が暗黙知の言語化で最も役に立つのは、正しい説明を出すときではなく、熟練者が反論したくなる下書きを出すときだ、ということです。LLMの強み、その強みが裏返る場面、確認の工程の組み立て方を順に考えます。
暗黙知は、本人の自覚が薄く、文脈に依存し、言葉の外にあります
暗黙知は、身体の技能、直感的な判断、状況に応じた柔軟な意思決定、長年の勘が一体になった知識です。言葉にするのが難しい理由は三つあります。
- 本人の自覚が薄い:「なぜか分からないが、体が動く」という状態
- 文脈に依存する:状況や環境で判断が変わり、定型にしにくい
- 言葉以外の要素が大きい:身ぶり、体のバランス、声のトーンなど
一つ目の理由は、あとで効いてきます。本人の自覚が薄い知識ほど、他人が書いた説明を、自分の知識として受け入れやすいからです。
LLMの強みは、束ねる、問いを重ねる、形を変える、の三つです
一つめは、まとまりのない言葉を束ねる力です。熟練者の発話、会話の記録、現場のメモ、社内文書の断片を読み込み、一貫した文章に組み直せます。人が読む前に疲れてしまう量でも、関連する箇所を抜き出せます。
二つめは、聞き手になれることです。対話を通じて熟練者に追加の質問を重ね、断片を少しずつ掘り起こせます。
三つめは、説明の形を変えられることです。たとえ話を添える、別の分野の概念と比べる、箇条書きと物語調を切り替える。その過程で、本人も気づかなかった視点が見つかることがあります。
もっともらしい仮説は、本人の記憶を上書きしかねません
ところが、三つの強みはどれも、裏返すと同じ危険を持っています。束ねれば平均化され、形を変えれば滑らかになります。LLMが出す仮説は、記録のどこにも書かれていない理由まで、自然な文章で埋めてくれます。
自覚の薄い熟練者がその文章を読むと、違和感の小さい説明ほど、そうだった気がしてきます。熟練者の勘をLLMに要約させ、本人にうなずいてもらう工程は、確認ではなく署名集めです。うなずいた時点で、AIの書いた理由が、組織の正式な暗黙知になってしまうからです。
LLMの説明が熟練者の記憶をどの程度変えるのかは、十分に確かめられているとは言えません。ただ、流暢な説明が正しく見えやすいこと、自覚の薄い知識は外からの説明に引っぱられやすいことを考えると、確認の工程を楽観的に設計する理由はありません。

確認は、合っているかではなく、どこが違うかを探す工程にします
流れそのものは、記録する、整理する、仮説を出す、本人が確かめる、展開する、で変わりません。変えるのは、各工程の頼み方です。
- 記録する:ロングインタビューの録音や、作業しながら考えを声に出してもらう思考発話を残す。本人の言葉が先にあることが、後の確認の物差しになる
- 整理する:よく出るキーワードや判断基準を分類させる。熟練者がどこを強い自信で語り、どこを曖昧に語っているかの差も一緒に出させる
- 仮説を出す:一つの説明ではなく、互いに食い違う仮説を複数出させる
- 本人が確かめる:「合っていますか」ではなく「どれが一番違いますか」と聞く
- 展開する:確かめた内容を、どの記録に基づくかの印をつけて、教材やナレッジベースにする
仮説を出させるときの問い方の例です。
作業記録と点検記録を読み、熟練者がこの場面で作業を止めた理由について、互いに食い違う仮説を三つ出してください。それぞれについて、仮説を支える記録と、仮説と矛盾する記録を挙げてください。記録にない理由を推測で書いた場合は、推測と明記してください。候補が一つしかないと、本人は賛成か反対かしか選べません。三つあると、どれが近く、どれが違い、なぜ違うのかを語り始めます。暗黙知が言葉になるのは、たいていその「なぜ違うか」の部分です。
現場では、記録の種類ごとに使い方が変わります
職人技の継承では、作業映像に本人の説明音声を重ねて記録し、要点と因果を整理します。ソフトウェア開発では、プルリクエストのコメントやチケットのやり取りから、バグを見つける着眼点や設計の優先順位を抽出します。本人が「言うまでもない」と思っている部分こそ、他の人には大事な暗黙知であることが多いものです。カスタマーサポートでは、ベテランの通話記録やチャット履歴から、潜在的な要望を察するコツを取り出せます。
注意点は三つあります。第一に、ハルシネーションです。出力がどの記録を参照したかを示させ、本人の確認を必ず通します。第二に、機密と個人情報です。外部のサービスにそのまま入力せず、匿名化する、社内で運用できる環境を使うなどの対策が要ります。第三に、すべては言葉にできないことです。身体や感覚に根ざした部分は、最後はOJTや実習で学ぶしかありません。
あなたの組織で、AIがまとめた手順書や判断基準に対して「ここは違う」と言える人は誰でしょうか。その人は、実際にそう言う時間と立場を与えられているでしょうか。
この記事の背景にある考え方は、拙著『GoogleのAI NotebookLM 意思決定の強化書』(NotebookLMは2026年7月にGemini Notebookへ名称が変わりました)の3章4節「情報を噛み砕き「知見」として吸収する」に書きました。AIの答えを鵜呑みにせず問い直す手順を扱い、「回答の中で違和感や引っかかりを覚えた点こそが深掘りの入口です。」と書いています。この節を読むと、AIの出した説明に対する小さな違和感を、聞き流さずに自分の知見へ変えていく問い直し方を考えられるようになります。
同じ資料を見ているのに、なぜ結論が割れるのか。
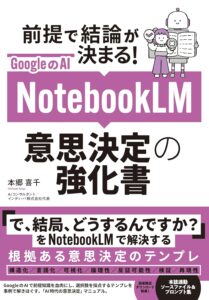
『GoogleのAI NotebookLM 意思決定の強化書』
前提が結論を決める。意思決定を根拠、前提、結論の三層に分け、前提を対象、目的、制約、評価基準の四つで言葉にする本です。
読み終えたとき、手元に残るもの
- 意思決定の設計図になる前提リスト
- 資料を事実、意見、噂、ゴミに仕分けるFORT
- 同じ物差しで比べる選択肢表と採点表
- 始める条件と止める条件を書いた決定書
NotebookLMは2026年7月にGemini Notebookへ名称が変わりました。本の手法は、使うAIの種類を問いません。