
50MB、1,000ページ、3,000ファイル。AIの仕様表の数字は頼もしく見えますが、日付のない仕様表で導入を決めるのは、去年の時刻表で今日の電車に乗ろうとするのと同じです。時刻表は正しかったのに、乗り遅れます。
この記事では、Gemini 2.0 Flashが2025年2月の公開時点で扱えたPDFの仕様を紹介したうえで、その数字が時間とともにどう古くなるか、古くなっても使える読み方は何かを考えます。
2025年2月時点のGemini 2.0 Flashは、PDFを画像として読みました
Gemini 2.0 Flashは、Googleが開発した大規模言語モデルで、テキスト、コード、画像、音声などを入力として受け取れます。PDFは画像として処理され、1ページが1枚の画像として扱われました。本文の文字だけでなく、図表やレイアウトも読み取れる可能性があるということです。出力はテキスト、コード、JSON形式で、画像や音声の出力は今後追加される予定とされていました。
公開時点の仕様は次のとおりでした
| 項目 | 仕様(2025年2月時点) |
| 最大ファイルサイズ | 50MB/ファイル |
| 最大ページ数 | 1,000ページ |
| 最大ファイル数 | 3,000ファイル |
| 知識のカットオフ | 2024年6月 |
当時の整理では、1ページのPDFを3,000本、300ページのPDFを10本、1,000ページのPDFを3本、といった組み合わせが挙げられていました。ページ数の上限はモデルが扱える画像の枚数に左右され、一度に処理できる量の上限として、入力と出力を合わせて1,048,576トークンのコンテキストウィンドウがありました。APIのレート制限は、1分あたり10リクエスト、1日あたり1,500リクエスト、1分あたりのトークン数400万とされていました。
制限と評価は、出どころによって重みが違います
公開時点のGemini 2.0 Flashは試験運用版で、いくつかの制限が指摘されていました。専用のOCR機能は備わっていないとされ、スキャンしたPDFは事前にOCRソフトでテキスト化することが勧められていました。表や図の多いPDFを正しく処理できない場合や、大きなファイルで時間がかかったりエラーになったりする場合もありました。長文や特定の語句でのエラーもユーザーフォーラムで報告されていましたが、原因は推測の段階でした。
一方で、質の悪いスキャン、複数言語、複雑な表を含むPDFで読み取り精度を測るrd-tablebenchというベンチマークでは、高いスコアを記録したと報告されています。同じ、スキャンや表をどこまで読めるか、について、資料によって見立てが違ったわけです。

迷ったときは、数字の出どころで分けます。提供元の仕様は事実として扱えます。フォーラムの報告は、起きうることの手がかりです。ベンチマークは、試験の条件の中での結果です。どれも、自分の手元のPDFで同じ結果が出る保証ではありません。
比較表は、比べた相手の時点まで確かめます
公開時点の比較では、Claude 2は1ファイル30MBまで、1チャットあたり20ファイルまでとされ、Gemini 2.0 Flashはファイルの大きさとページ数で上回っていました。ただ、比較相手のClaude 2は、2025年2月の時点ですでに後継の世代のモデルが出ていました。同じ表でGPT-4やLLaMA 2の欄には、情報なしが並んでいました。
新しいモデルを一世代前の他社モデルと並べた比較は、去年の記録と今年の記録を並べて新記録と呼ぶようなものです。比較表を読むときは、勝ち負けより先に、比べた相手がいつの版なのかを確かめます。情報なしの欄は、劣っているという意味ではなく、比べられていないという意味です。
数字は古くなっても、読み方は残ります
この記事の表は、2025年2月には事実でした。2026年10月の今これを読む人にとっては、確かめ直すまでは使えない情報です。AIの仕様は数か月単位で変わり、モデル自体が新しい版に置き換わることもあります。Gemini 2.0 Flashの現在の提供状況や仕様は、この記事では確かめていません。
古くならないのは、使う前の確かめ方です。数字を事実、報告、試験結果に分けて並べ、それぞれの日付を書く。自社のスキャン資料と表の多い資料を一本ずつ試す。読み違いが出たら、OCRで前処理する、分割する、表だけ別に渡す、といった対策と、最終確認をする人を決める。何を読ませたいのか、どこまでの誤りなら許せるのかという前提が決まって初めて、50MBや1,000ページという数字が意味を持ちます。
逆に、特定のモデルの特定の版に固定して運用している環境なら、その版の仕様表は引き続き有効です。鮮度が問題になるのは、版が変わったことに気づかないまま古い数字を使い続ける場合です。
あなたの社内でAIの導入判断に使われている仕様の数字には、いつ時点の数字かが書かれているでしょうか。その数字を最後に確かめ直したのは、誰でしょうか。
この記事の背景にある考え方は、拙著『GoogleのAI NotebookLM 意思決定の強化書』の2章1節「ソースの品質がすべての土台」に書きました。「つまり、ソースの真偽・鮮度の最終責任は人間側に残ります。」この節を読むと、手元の資料のうちどれが古い予測で、どれが最新の事実なのかを、AIに任せる前に自分で問う習慣の意味が分かります。
同じ資料を見ているのに、なぜ結論が割れるのか。
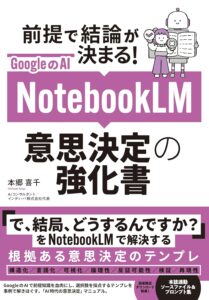
『GoogleのAI NotebookLM 意思決定の強化書』
前提が結論を決める。意思決定を根拠、前提、結論の三層に分け、前提を対象、目的、制約、評価基準の四つで言葉にする本です。
読み終えたとき、手元に残るもの
- 意思決定の設計図になる前提リスト
- 資料を事実、意見、噂、ゴミに仕分けるFORT
- 同じ物差しで比べる選択肢表と採点表
- 始める条件と止める条件を書いた決定書
NotebookLMは2026年7月にGemini Notebookへ名称が変わりました。本の手法は、使うAIの種類を問いません。