
導入の検討会で、担当者が公開ベンチマーク(AIの性能を比べる共通テスト)の順位表を映した。
全員が、一位のモデルに手を挙げた。
三か月後、課長が問い合わせへの返信の下書きを読み、首をかしげた。
敬語の使い方が、自社の決まりと違っていた。
全員が選んだ一位のモデルが、なぜ自社の返信でつまずいたのか。
順位表は、誰の物差しで測っているのか
代表的な公開ベンチマークに、MMLUがある。採点の対象は、57分野にわたる15,000問以上の選択問題への正答だ。
2020年、研究者のヘンドリクスらがMMLUを発表した。分野は、初等数学から米国史、法律まで及ぶ。
発表の時点で、最大のGPT-3でも、でたらめに選ぶ場合を平均20ポイント近く上回る程度だった。57分野のどれでも、専門家の水準に届いていない。
MMLUは、知識の幅を測るために作った物差しである。
自社の問い合わせに礼儀正しく正確に答える力は、MMLUの問題の外にある。
ここに落とし穴がある。順位表を見て選ぶ限り、次の一位に乗り換えても、自社の基準は表の外に残る。
三か月ごとにモデルを替えても、課長は三か月ごとに首をかしげることになる。
一位のモデルがつまずいた理由の正体
カラクリは単純だ。順位表が測ったのは、ほかの誰かが選んだ問題への正答である。
電卓なら、答えが合うかを見れば評価は終わる。
従来のソフトウェアの評価は、仕様どおりに動くかを問うた。答えは、合格か不合格かの二択だった。
生成AIは、同じ質問にも毎回違う答えを返す。文章の正解も、何通りもある。
問いは、どれだけ優れた出力か、に変わる。品質、速度とコスト、偏りへの配慮など、いくつもの軸で確かめる。
どれだけ優れているかは、誰かの物差しを当てないと決まらない。一位のモデルは、他人の物差しで一位だった。
生成AIの評価では、良い出力の条件を先に言葉にする。言葉にした条件で、出力を測る。
AIに採点させても、物差しは誰かが書く
評価の方法は、大きく三つある。
自動評価は、数値の指標で機械的に採点する。速く安く、何度でも同じ結果が出る。
文脈や細かな言い回しは、指標の外に残る。
人間評価は、専門家が基準に沿って採点する。評価のゴールドスタンダード(最も信頼の厚い方法)と呼ぶ人が多い。
人間評価には、時間と費用がかかる。
二つの間を埋めるのが、AIによる採点(LLM as a Judge)だ。高性能なAIに、別のAIの出力を採点させる。
2023年、Zhengらの研究は、審査役のGPT-4の評価が人の好みと8割を超えて一致したと報告した。人同士の一致と同じ水準である。
心強い数字に見える。だが審査役のAIも、渡された基準でしか測らない。
どの方法を選んでも、基準を書く仕事は残る。変わるのは、基準を書く場所だ。
自社の敬語の決まりを書かずに採点を任せれば、審査役も敬語の違いを見逃すおそれがある。
成果を出した企業は、物差しを自分で作った
メルカリは、写真を撮るだけで商品のタイトルと説明文を作るAI出品サポートを開発した。出品の時間は、数分から約15秒に縮んだ。
同社は、成功の鍵は、プロンプトの工夫やRAG(外部の資料を探して答えに使う仕組み)以上に、質の高い評価を続けることにあるとした。
評価は、簡単な指標、AIによる採点、専門家の確かめ、の段階で回した。
臨床の質問に答えるClinicalKey AIの評価には、41名の専門医と薬剤師が加わった。最も重く見たのは、患者に害を及ぼす可能性である。
サイバーエージェントは、広告の多様性や文字数などの制約の順守を測る、独自のベンチマークを作っている。
三社の基準は、ばらばらだ。三社とも、自分たちの事業で何が成功で何が失敗かを先に決めた。
十件の採点表を、そのままプロンプトに写す
生成AIの導入は、順位表を見る前に、十件ほどの採点表を作るところから始める。
採点表は、十件ほどの入力を縦に並べた表だ。横には、期待する出力と合否の基準を書く。
良い答えなら見れば分かる、という感覚は、本人の頭の中にある。
採点表に書いた基準なら、ほかの人も、明日の自分も、同じ基準で出力を測れる。
採点表の合否の基準は、プロンプトに同じ文言で写せる。前提の段の下に、合格の基準の段を足す。
何を良しとするかを言葉にするのは、AIを使う人の仕事である。次の文面のかっこの中を、自分の仕事に書き換えて使える。
(例:問い合わせメールへの返信の下書き)を作ってください。
前提:(例:既存のお客様への返信です。社内の敬語の決まりに沿わせます)
合格の基準:(例:質問に一文目で答える。料金の質問は担当者に回すと書き添える。300字以内)
最後に、下書きが基準を一つずつ満たしたかを、表で示してください。
返ってきた下書きは、採点表と同じ基準で一行ずつ測る。
順位表の外にあった、一行の決まり
検討会で手を挙げる前に、採点表に一行だけ足せばよかった。社内の敬語の決まりに沿うこと、と。
一位の順位表に、自社の敬語の決まりは一行も載っていなかった。
この記事の考え方は、拙著『ChatGPT はじめてのプロンプトエンジニアリング』の4章3節、評価基準を人が決めてAIに採点させる節に書きました。この節を読むと、AIに採点を任せる前に、どの重みが自分の価値観で、どこが借り物かを確かめられるようになります。
AIの答えが物足りないとき、疑うべきはAIか、自分の言葉か。
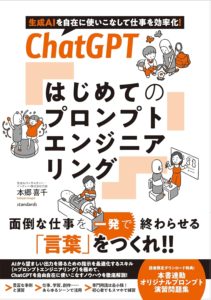
『ChatGPT はじめてのプロンプトエンジニアリング』
AIは言葉でしか動かない。プロンプトを暗記するのをやめ、構成要素に分解して、自分の言葉で意図を込める力を鍛える本です。
読み終えたとき、手元に残るもの
- 必須、任意、形式の三つに分けたプロンプトの構造
- 回答の質を変える、意図を込めた生きたプロンプト
- 発注と検収は人が担う、AIとの役割分担
- 章末の演習プロンプト26題
4刷重版。全国の大学図書館65館が所蔵しています(2026年10月時点)。
出典
- Evaluating Generative AI: Overcoming Challenges in a Complex Landscape
- Top 5 criteria for developers when adopting generative AI|IBM
- 生成AIをビジネス活用する上で押さえるべき8つの評価観点|DOORS
- Define your evaluation metrics|Generative AI on Vertex AI|Google Cloud
- MMLU Benchmark: Evaluating Multitask AI Models|Zilliz
- Measuring Massive Multitask Language Understanding(Hendrycks ほか、arXiv、2020年)
- Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena(Zheng ほか、arXiv、2023年)