
POSTならパラメータはURLに出ないから安心、という説明は、半分だけ正しい説明です。本文に入れたデータは、道の途中で見えにくくなるだけで、届いた先では一字一句そのまま読めます。この記事では、ユーザー登録のリクエストを例にPOSTの組み立てを読み、本文が隠し場所ではなく相手の手元に届いて残る場所だということ、それがGPTsのアクションで何を意味するのかを考えます。
リクエストは、三つの部分でできています
Webサイトでユーザー登録をするときに送られるリクエストは、たとえば次のような形です。
POST /register HTTP/1.1
Host: example.com
Content-Type: application/x-www-form-urlencoded

username=johndoe&password=securepassword123&email=johndoe@example.com
- リクエストライン:POST がHTTPメソッド、/register が送り先の住所(エンドポイント)、HTTP/1.1 が使うHTTPの版
- ヘッダー:Host で送り先のホスト名を、Content-Type で本文の形式を示す。application/x-www-form-urlencoded は通常のフォームのデータの形式
- ボディ:空行の後ろの部分。送りたいパラメータが入る
ボディの中は、名前と値を = でつなぎ、組と組を & で区切っています。書き方はGETのクエリストリングと同じで、置き場所がURLではなく本文になっています。JSONで送るなら、Content-Type を application/json にし、本文を波かっこで囲んだJSONの形で書きます。フォーム形式はWebページの入力欄から送るときに、入れ子のある複雑なデータも表せるJSONは、プログラムどうしのAPIでよく使われます。
| パラメータ | 役割 | 例の値 |
| username | 新しく登録するユーザー名 | johndoe |
| password | ユーザーのパスワード | securepassword123 |
| ユーザーのメールアドレス | johndoe@example.com |
本文は、見えにくい場所であって、見えない場所ではありません
POSTの特徴として、URLに表示されない、多くのデータを送れる、通常はキャッシュされない、フォームの送信やデータの作成や更新に使う、が挙がります。一つ目は確かにGETとの大きな違いで、URLの共有や履歴から情報が見えることはなくなります。
ただし、通信の途中で読まれないようにするのはPOSTではなく、HTTPSによる暗号化です。そしてHTTPSが守るのも、途中の道だけです。サーバーに届いた時点で暗号は解かれ、上の例なら securepassword123 という文字列が、そのままサーバーのプログラムに渡ります。パスワードをハッシュ化して保存するのが一般的なのは、まさに届いた先で丸見えだからです。封筒に入れたから安心、と言うのは、封筒を開ける相手が誰かを確かめてから言うべき言葉です。
届いた先で何が起きるかは、送る側からは見えません。受け取ったリクエストの本文を、不具合の調査のために記録に書き出す設定のサーバーもあります。そうなれば、URLには出なかったはずの値が、記録の中に平文で残ります。送る側に確かめられるのは、相手を信頼してよいかどうかだけです。
GPTsのアクションでは、本文を組み立てるのがAIです
GPTsのアクションでは、POSTで送る値をスキーマの requestBody に、形式(application/json など)と、各項目の名前、型、説明で定義します。GPTsは、この定義と会話の内容から本文の値を組み立てて送ります。
ここで本文の性質が効いてきます。会話の中で利用者が話した名前や連絡先、社内の事情は、項目の説明に合うと判断されれば本文に入り、つなぎ先のサーバーに届いて、その運営者の手元に残ります。URLに出ないので、利用者がそれに気づく手がかりはさらに少なくなります。POSTを選んだことで安全になったのは、ブラウザの履歴に残らないという点だけで、誰の手元に何が渡るかは何も変わっていません。
では、送らせてよい項目はどう決めるのか。つなぎ先が自分の管理するスプレッドシートなのか、他社のサービスなのかで、答えは変わります。送る前に利用者の確認をはさむ設計にしても、確認画面で利用者がどこまで中身を読むかは分かりません。どこで線を引けば十分なのかについて、仕組みの側から言える一般的な正解はありません。
あなたのGPTsがPOSTで送る項目は、つなぎ先のどこに、どれくらいの期間残るでしょうか。その相手に、その項目を渡してよいと誰が決めたでしょうか。
この記事の背景にある考え方は、拙著『ChatGPT 誰でも1時間でできる! はじめてのGPTsのつくり方』の3章7節「考えるGPT」に書きました。基準を言葉にしてAIに組み込めば判断は速く透明になるが、AIは責任を負えないので、決めるところは人に残る、という話です。そこには「最終的な判断は依然として人間が行う必要があります。」とあります。この節を読むと、本文に入れて送らせる項目の一つひとつを、AIの組み立てに任せる作業ではなく、誰に何を渡すかという自分の判断として見直せるようになります。
自分の仕事に効くAIは、誰が作るべきか。
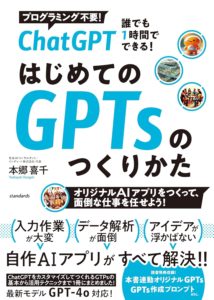
『ChatGPT 誰でも1時間でできる! はじめてのGPTsのつくり方』
要件を日本語で書き出せば、それがそのままAIを動かす。現場の知識を持つ人が自分で作り、育てる、内製化のための本です。
読み終えたとき、手元に残るもの
- 目的、役割、入力、出力をそろえる要件定義の型
- 評価基準と判断基準を持たせる考えるGPTの作り方
- テスト用のダミーデータで直していく手順
- 複数のGPTを分業と協業でつなぐ設計
画面や機能の記述は2024年時点のものです。仕事を分解し、基準を言葉にする考え方は今も変わりません。