
公開ランキングで一位のモデルを、一位だったという理由で導入するのは、他人の入試の合格点で自分の志望校を決めるようなものです。その点数は、誰かが自分の目的と評価基準で測った結果で、あなたの仕事で何を間違えると困るのかは、一行も考慮されていません。この記事では、生成AIの代表的な評価軸と指標が何を前提にしているかを確かめ、自社で使うAIの軸を、点数表から借りずに失敗のコストから逆算して決める手順を示します。
評価軸は、何を良しとするかという前提の表明です
生成AIの評価軸は、おおむね次の八つに整理されます。
- 品質:出力の出来ばえ
- 多様性と創造性:似た出力ばかりにならないか、独創的か
- 一貫性と文脈:話の筋や設定が前後で矛盾しないか
- 事実性:根拠のない情報をもっともらしく作っていないか
- 使いやすさ:応答の速さ、操作の分かりやすさ、満足度
- 安全性と倫理:有害な表現や偏りを抑えられているか
- 計算資源:処理の速さ、同時処理の能力、コスト
- 汎用性:幅広いタスクや、学習していない課題にも対応できるか
この一覧は、何を測れるかの目録であって、何を測るべきかの答えではありません。八つ全部に同じ重みを付けた比較表は、公平に見えて、実は何も選んでいない表です。すべてを同じだけ大事にするという判断は、何を優先するかを決めないという判断と同じだからです。
よく使われる指標にも、それぞれ前提が埋め込まれています
| 指標 | 何を測るか | 置いている前提 |
| BLEU | 参照文と語の並びがどれだけ一致するか(機械翻訳向けに開発) | 正解の文が用意でき、表面の一致が良さを表す |
| ROUGE | 参照文との語の重なり(要約でよく使う) | 良い要約は参照の要約と同じ語を使う |
| METEOR | 語形変化や同義語も考慮した一致 | 言語や分野ごとの調整が済んでいる |
| Perplexity | 次の語をどれだけ予測しにくいか(低いほど良い) | 予測しやすい文章が良い文章である |
画像生成では、生成画像の特徴の分布が実際の画像にどれだけ近いかを測るFIDやInception Score、多様性では生成結果同士の重なりを測るSelf-BLEUなどが使われます。どの指標も、それぞれの前提の範囲では役に立ちます。しかし、自社の企画書の下書きにAIを使うなら参照文はありませんし、予測しやすい文章が良い企画書とも限りません。点数を目標にすると点数を上げること自体が目的になり、本来測りたかったものから離れていく、という問題も広く知られています。
自分の軸は、失敗のコストから逆算します
まず、その仕事でAIが間違えたときに何が起きるかを書き出します。
- 契約や数字を扱う文書:もっともらしい誤り(ハルシネーション)のコストが大きい。事実性を最優先にし、正解データや外部の資料との照合、人による確認を組み込む
- 企画の発想出し:誤りのコストは小さく、似た案ばかりになるコストのほうが大きい。多様性を重く見る
- 顧客に直接返す応答:差別的な表現や不適切な言い回しのコストが大きい。安全性を外せない条件にする
- スマートフォンのアプリ:遅さとメモリの使用量が、利用をやめる理由になる。速さを条件にする

失敗のコストは、仕事ごとに偏っています。誤りを一つ見逃すと大きな損失になる仕事では、平均的によくできることより、致命的な誤りが少ないことが大切です。十の案のうち一つ使えれば十分な仕事では、平均点より、当たりの案が出る幅のほうが大切です。同じAIでも、仕事が変われば評価は逆になり得ます。
応答の待ち時間、同時にさばける量、利用料金のような運用の軸は、採点するより、満たさない候補を即座に外す条件として置くほうが判断しやすくなります。満たさなければ除外するものが制約で、程度で判断が変わるものが評価基準です。軸が決まったら、公開の点数ではなく、自分の業務の実例をいくつか用意して候補に同じ課題を解かせ、流暢さ、一貫性、関連性などを人が5段階で採点します。
失敗のコストが見積もれない場面もあります
この方法には弱点があります。まだ誰もやったことのない用途では、何を間違えると困るのかが、使ってみるまで分かりません。その場合は、小さく試して失敗の型を集めることから始めるしかありません。2024年時点では、AIの出力を別のAIに採点させる手法も研究されていますが、その採点者が何を良しとしているかという前提も、同じように問われます。評価する道具を評価する道具が要る、という入れ子は、どこかで人が引き受けて止めるしかありません。
あなたの仕事でAIが一度だけ大きく間違えるとしたら、どんな間違いがいちばん高くつくでしょうか。いま使っているAIを選んだとき、その間違いを基準に比べた人はいたでしょうか。
この記事の背景にある考え方は、拙著『GoogleのAI NotebookLM 意思決定の強化書』の4章3節「理念書と評価基準を作る」に書きました。組織が持ち続ける原則と、案件ごとに作る評価軸と重み付けを分け、「理念は抽象的なもので、評価基準は具体的なものです。」と書いています。読むと、自分たちの原則から、今回の選定に使う評価軸と重みを自分の手で引き出す筋道が見えてきます。
同じ資料を見ているのに、なぜ結論が割れるのか。
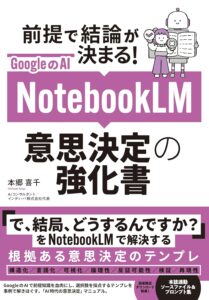
『GoogleのAI NotebookLM 意思決定の強化書』
前提が結論を決める。意思決定を根拠、前提、結論の三層に分け、前提を対象、目的、制約、評価基準の四つで言葉にする本です。
読み終えたとき、手元に残るもの
- 意思決定の設計図になる前提リスト
- 資料を事実、意見、噂、ゴミに仕分けるFORT
- 同じ物差しで比べる選択肢表と採点表
- 始める条件と止める条件を書いた決定書
NotebookLMは2026年7月にGemini Notebookへ名称が変わりました。本の手法は、使うAIの種類を問いません。